【宣伝】Navier--Stokes 方程式の有限時間爆発解の解説本を販売します

こんにちは。

この度、新しい本を販売することになりました。タイトルは『Navier–Stokes方程式 有限時間爆発解 ― 構成的証明の詳解』です。今回は上下巻の2冊構成で、上巻が「数学的準備」、下巻が「解の構成」になっています。簡単にどんな本なのか紹介します。

購入リンク:

どんな本?

2026年、OpenAI から ''Finite Time Blowup for Navier–Stokes'' という論文が公開されました*1。これはかの有名なミレニアム懸賞問題の一つ*2を解決したと主張する論文で、しかも AI の力をフル活用して解決したとあって、今まさに世間の注目を集めています。

私は博士課程まで数値流体力学を研究していて、扱っていたのがまさに Navier–Stokes 方程式でした。そのため、この論文が公開されたときに「せっかくなのでちゃんと理解したい」と思ったのが、この本を作り始めたきっかけです。

ただ、原論文を読むにはかなり多くの数学的準備が必要です。そこで、原論文だけを解説するのではなく、必要な数学を整理するところから始めて、最終的に証明全体まで辿れるようにしよう、と考えました。

その結果できたのが、この上下巻です。上巻では下巻を読むための数学を準備し、下巻では原論文の構成と証明を主定理まで追います。原論文を横に置いて逐語的に読むための本というより、必要な議論を組み直して、一続きの本として読めるようにしたものです。

想定している読者は、数学科の学部課程を修了した程度の知識を持っている人です。測度論、Fourier 解析、関数解析、多変数解析などの基礎は前提にしていますが、Navier–Stokes 理論や高度な偏微分方程式論の専門知識は前提にしていません。

上巻:数学的準備

上巻はこちら

上巻では、下巻の証明で実際に使う数学をまとめています。

内容は、Fourier 解析や Sobolev 空間、Riesz 変換と圧力評価といった解析の基礎から始まり、自己相似変数、エネルギー評価、円筒座標での正則性へ進みます。さらに、多重スケール構成、振動による応力の実現、モーメント補正、形式的な構成から滑らかな場を作る方法など、原論文特有の構成を理解するための道具を扱います。

普通の教科書のように関連分野を網羅するのではなく、「下巻を読むために必要なもの」を中心に構成しています。また、長い証明の中で現在地を見失いにくいように、章の途中に初読のヒントや状況の整理を行うブロックなどを入れています。巻末には上巻と下巻の対応表や、記号・スケールの整理も載せています。

下巻:解の構成

下巻はこちら

下巻では、OpenAI の論文の構成的証明そのものを扱います。

自己相似座標の導入から始めて、爆発する解の基本となるプロファイルを作り、それらを接続し、振動場によって必要な応力を実現し、残る誤差を修正していきます。最後は局所的に作った場を全空間へ移し、外力と解を構成して主定理まで到達します。

細かい計算を紹介する本というより、「なぜこの構成が必要なのか」「各段階で何を作っているのか」「それが次の段階にどうつながるのか」が追えるようにすることを意識しています。

原論文は166ページですが、前提となる数学や途中の議論を展開していくと、それだけでは済みませんでした。結果として、上下巻あわせて600ページ近い本になっています。

AIを使って制作しました

実は今回の本は、複数の AI モデルをガンガン使って制作しました。

構成の検討、原稿作成、レビュー、翻訳・照合などに AI を使い、私は企画の出発点と大枠の方針を決め、制作ワークフローを設計しながら進めました。数学的内容についても、複数モデルによるレビュー、原論文との照合、依存関係の確認、機械的検査、修正後の再確認などを行っています。

ただし、独立した人間の専門家による査読を受けた本ではありません。その点では、通常の専門書とは検証方法が異なります。

個人的には、「自分がまだ理解していない最先端の論文を、AIを使って必要な知識から逆算し、どこまで体系的に理解できるか」という試みでもありました。その成果物としてできたのが、この2冊です。

こんな人に

OpenAI の Navier–Stokes 論文を読んでみたい人、有限時間爆発の構成がどうなっているのか知りたい人、現代的な偏微分方程式の長い構成的証明を実際に追ってみたい人には、特に面白い本になっていると思います。

また、AIを使って高度な数学を学ぶ・整理する・本にする、という制作方法そのものに興味がある人にも読んでもらえればと思います。

最後に

改めて購入リンクを貼っておきます。

上巻「数学的準備」↓
BOOTH - 創作物の総合マーケットsmooth-pudding.booth.pm

下巻「解の構成」↓
smooth-pudding.booth.pm

興味のある方はぜひ読んでみてください!

ではまた。
Ball の立方体切断定理 Part 3

前回の記事で Ball の積分不等式を証明し、無事 Ball の立方体切断定理は証明されました。

smooth-pudding.hatenablog.com

今回、この証明をずっと簡略化した証明を Astra さんに教えてもらったので、紹介しようと思います。

元ネタ

Astra さんによると、以下の論文を参考にしたようです。
arxiv.org

この論文の論法をベースとして、各種評価を簡略化したものを紹介します。

Ball の積分不等式(復習)

Ball の積分不等式とは以下の主張でした。今回はこの主張の別証明を与えていきます。

主定理 (Ball の積分不等式). 任意の p \geq 2 に対して、以下が成立する。

\displaystyle\int_{\mathbb{R}} \left| \mathrm{sinc} \, x \right|^{p} \mathrm{d} x \leq \sqrt{\dfrac{2}{p}}

等号は p = 2 でのみ成立する。

ただし \mathrm{sinc}\,x は以下で定義します。

\displaystyle
  \mathrm{sinc}\, x = \begin{cases}
    1 & (x = 0), \\
    \dfrac{\sin \pi x}{\pi x} & (x \neq 0)
  \end{cases}

中心的アイディア

まず以下のように置きます。

\displaystyle
  f(x) = e^{- \pi x^{2}}, \quad
  g(x) = \left( \mathrm{sinc}\, x \right)^{2}

これらを使い、主定理の積分範囲を [0, \infty) に制限すれば、示すべき不等式は以下になります*1
\displaystyle
  \int_{0}^{\infty} g(x)^{q} d x
  \leq \int_{0}^{\infty} f(x)^{q} d x

ただし q = p / 2 と置きました。等号成立は q = 1 のみです。

関数 T \colon [0, \infty) \to [0, \infty)

\displaystyle
  \int_{0}^{T(x)} f(t) dt = \int_{0}^{x} g(t) dt

を満たすものとして定義します。両辺を x で微分すると
\displaystyle
  f(T(x)) T'(x) = g(x)

が得られます。もし T が全射であり、かつ 0 \leq T'(x) < 1 が成り立つなら、主張は直ちに従います。実際
\displaystyle
  \begin{aligned}
    \int_{0}^{\infty} g(x)^{q} dx
    &= \int_{0}^{\infty} f(T(x))^{q} T'(x)^{q} dx \\
    &\leq \int_{0}^{\infty} f(T(x))^{q} T'(x) dx \\
    &= \int_{0}^{\infty} f(y)^{q} dy
  \end{aligned}

と計算できます。等号成立は明らかに q = 1 の場合のみです*2

上記ではいろいろな性質をナイーブに用いてしまっているので、以下ではひとつひとつ証明していきます。

T(x) の存在とその性質

f, g を前の章で与えられたものとします。これらの第一積分 F, G を以下で定義します。

\displaystyle
    F(x) = \int_{0}^{x} f(t) dt, \quad
    G(x) = \int_{0}^{x} g(t) dt

まず f の連続性から FC^{1} 級であることが分かります。f(x) > 0 であることから F(x) は狭義単調増加になります。よって写像

\displaystyle
  F \colon \mathbb{R} \to \left( -\dfrac{1}{2}, \dfrac{1}{2} \right)

の逆写像
\displaystyle
  F^{-1} \colon \left( -\dfrac{1}{2}, \dfrac{1}{2} \right) \to \mathbb{R}

が存在し、C^{1} 級となります*3。特に狭義単調増加です。

また g の連続性から GC^{1} 級となります。またほとんどすべての x に対して g(x) > 0 なので G(x) は狭義単調増加です。さらに

\displaystyle
  \lim_{x \to \pm \infty} G(x) = \pm \dfrac{1}{2}

なので  - 1/2 < G(x) < 1/2 が成り立ちます。

以上から T \colon \mathbb{R} \to \mathbb{R}T = F^{-1} \circ G と定義すれば、TC^{1} 級で

\displaystyle
  F(T(x)) = G(x)

を満たします。微分可能性が分かったので、辺々を微分して
\displaystyle
  f(T(x)) T'(x) = g(x)

も得られます。さらに F^{-1}, G がともに狭義単調増加であることから T も単調増加なので T'(x) \geq 0 が従います。

T'(x) < 1 の証明

x > 0T'(x) < 1 であることを示します。前章で示した等式から

\displaystyle
  T'(x) = \dfrac{g(x)}{f(T(x))}

なので、g(x) < f(T(x))x > 0 で成り立つことを示すことが目標となります。

以下、0 < x < 1x \geq 1 の場合に分けて考えます。

0 < x < 1 の場合

まず \sin x が上に凸であることを利用して不等式を示します。0 < s < t < \pi に対して、原点と点 (t, \sin t) を結ぶ直線は

\displaystyle
  y = \dfrac{\sin t}{t} x

と表されます。この直線は (s, \sin s) より下側にあるので
\displaystyle
    \sin s \geq \dfrac{\sin t}{t} s = \dfrac{s}{t} \sin t

が成立します。これを利用すると
\displaystyle
  \begin{aligned}
    \dfrac{d}{dt} \log \dfrac{t}{\sin t}
    &= \dfrac{\sin t - t \cos t}{t \sin t} \\
    &= \dfrac{\displaystyle \int_{0}^{t} s \sin s ds}{t \sin t} \\
    &\geq \dfrac{\displaystyle \int_{0}^{t} s^{2} ds}{t^{2}} \\
    &= \dfrac{t}{3}
  \end{aligned}

が得られます。よってこれを積分することで
\displaystyle
  \log \dfrac{t}{\sin t} \geq \dfrac{t^{2}}{6}

すなわち
\displaystyle
  \dfrac{\sin t}{t} \leq e^{- t^{2} / 6}

が得られます。したがって 0 < x < 1 のときは
\displaystyle
  g(x) = \left( \dfrac{\sin \pi x}{\pi x} \right)^{2}
  \leq e^{- \pi^{2} x^{2} / 3}
  < e^{- \pi x^{2}}
  = f(x)

が成立します。ただし \pi > 3 を用いました。この結果から
\displaystyle
  F(T(x)) = G(x) \leq F(x)

が従うので、F の単調増加性より T(x) \leq x が成立します。

最後に f(x)x > 0 で単調減少であることを用いれば

\displaystyle
  g(x) < f(x) \leq f(T(x))

が従います。

x ≧ 1 の場合

積分の裾部分を評価します。

\displaystyle
  R(x) = \int_{x}^{\infty} g(t) dt, \quad
  S(y) = \int_{y}^{\infty} f(t) dt

とおきます。このとき R(x) = S(T(x)) が成り立ちます。

R(x) が単調減少であることを利用すると

\displaystyle
  \begin{aligned}
    2 R(x)
    &\geq R(x) + R\left(x + \dfrac{1}{2}\right) \\
    &= \int_{x}^{\infty} \left(
      \dfrac{\sin^{2} \pi t}{\pi^{2} t^{2}} + \dfrac{\cos^{2} \pi t}{\pi^{2} (t + 1/2)^{2}}
    \right) d t \\
    &\geq \dfrac{1}{\pi^{2}} \int_{x}^{\infty}
      \dfrac{\sin^{2} \pi t + \cos^{2} \pi t}{(t + 1/2)^{2}}
    dt \\
    &= \dfrac{1}{\pi^{2} (x + 1/2)}
  \end{aligned}

が得られます。これと x \geq 1 のとき x^{2} \geq (2 x + 1)/3 であることから
\displaystyle
  g(x) \leq \dfrac{1}{\pi^{2} x^{2}}
  \leq \dfrac{3}{\pi^{2} (2x + 1)}
  \leq 3 R(x)

となります。

一方、y > 0 に対して

\displaystyle
  S(y) = \int_{y}^{\infty} e^{- \pi t^{2}} dt
  \leq \dfrac{1}{y} \int_{y}^{\infty} t e^{- \pi t^{2}} dt
  = \dfrac{e^{- \pi y^{2}}}{2 \pi y}
  = \dfrac{f(y)}{2 \pi y}

が成立します。

さて、x \geq 1 に対して y = T(x) と置きます。T(0) = 0 および T の単調増加性から y > 0 です。y \leq 1 / 2 のときは、f が単調減少であることから

\displaystyle
  g(x) \leq \dfrac{1}{\pi^{2}}
  < e^{- \pi / 4} = f\left(\dfrac{1}{2}\right)
  \leq f(y)

が成立し*4y > 1 / 2 のときは
\displaystyle
  g(x) \leq 3 R(x) = 3 S(y)
  \leq \dfrac{3}{2 \pi y} f(y)
  < \dfrac{3}{\pi} f(y)
  < f(y)

が成立します。

まとめ

前回がんばってこねくりまわしていたのはなんだったんだ、と言わんばかりのシンプルな証明でした。いやはや、不等式評価の世界は奥が深いです。

ではまた。

*1:前回の記事でも似た計算を行ったので省略していますが、\displaystyle\int_{0}^{\infty} f(x)^{q} dx の計算は Gauss 積分に帰着されます。値は \dfrac{1}{2 \sqrt{q}} となります。

*2:厳密に言えば、T' \equiv 0 なら仮定から従いませんが、そんなわけないことは明らかでしょう。

*3:ここで \displaystyle\lim_{x \to \pm \infty} F(x) = \pm \dfrac{1}{2} であることを使っています。

*4:1 / \pi^{2} = 0.1013..., e^{-\pi / 4} = 0.4559...

問いが最も価値を持つ時代

AI、めちゃくちゃ便利ですね。

分からないことがあれば聞けばいい。計算してほしければ計算してくれる。知らない概念が出てきたら説明してくれる。難しければ「もっと簡単に」と言えばいいし、逆に詳しく知りたければいくらでも掘り下げられる。

ほんの数年前なら何冊も本を読んだり、検索結果を何ページも行ったり来たりしないと分からなかったようなことが、今では数秒で返ってきます。

ここまで来ると、一度はこう思うはずです。

もう勉強しなくてもいいのでは?

しかし、人類はこの手のことを何度も言ってきました。

計算機が出たときには、もう計算を覚えなくていいと言われた。検索エンジンが出たときには、もう知識を覚えなくていいと言われた。そして今、AI が出てきて、ついに考えることすら不要になるのではと言われています。

でも、なぜか毎回そうはなりません。

たぶん、そもそも我々が「勉強とは何をしているのか」を少し勘違いしているのだと思います。

今回は AI が学びの何を変えて、何を変えていないのかについて、思ったことをつらつらと書いてみたいと思います*1

勉強では「答え」だけを覚えているわけではない

勉強というと、多くの人は「答えを覚えること」を想像すると思います。

三平方の定理を覚える。二次方程式の解の公式を覚える。歴史上の出来事を覚える。たしかにそれはやっています。

でも、それと同時にもう一つ覚えています。「問い」です。

三平方の定理を習うとき、我々は

直角三角形の三つの辺の間には、何か普遍的な関係があるのではないか?

という問いも一緒に学んでいます。

これは、知ってしまうと非常に当たり前に見えます。でも、もし数学をほとんど学んだことがない人に直角三角形を一つ見せたとして、

この三つの辺の長さには、三角形によらず成り立つ何らかの関係があるのではないか

という問いを自然に立てられるでしょうか。おそらく、そんなに簡単ではありません。

我々は三平方の定理という「答え」だけを学校で教わっているのではありません。「ここには何か法則があるかもしれない」「こういうもの同士を比べることができる」「そもそもこれは問うに値する」ということまで一緒に教わっています。

考えてみると、これは相当大きいことです。

AI は「答え」を猛烈に安くした

AI が本当に革命的なのは、答えを得るコストをとんでもない勢いで下げたことです。

以前なら、本を探す、論文を探す、検索ワードを工夫する、必要な部分を読む、複数の情報を突き合わせる、といったことをしなければならなかった。今ではかなりの部分が、

AI に聞く

に圧縮されつつあります。

これはものすごい変化です。「答えを探すための技術」は、一気に「AI を使いこなす技術」に圧縮されている。

しかし、ここで妙なことが起きます。AI がどれだけ賢くなっても、

何を聞くのか

という問題は残るのです。

AI は「問い」に対して「答え」を出す

かなり乱暴に抽象化すると、AI は

問い → 答え

という機械です。

もちろん、「面白い問いを考えて」と言えば問いも出してくれます。しかし、その場合でも人間は、

何について問いを作らせるのか?

という一段上の問いをすでに持っています。それすら AI に決めてもらおうとすれば、今度は「自分は何について考えるべきなのか?」という問いが残る。どこまで登っても、最後には何らかの「問い」が必要になります。

逆に言えば、問いを一つも持っていない人間にとって、AI は何も始めてくれません。世界中の知識にアクセスできる機械が目の前にあっても、「何を知りたいのか」がなければ、そこから先には進めない。

AI は答えを持っていない人を救うことはできます。しかし、問いを持っていない人を救うことは、たぶんもっと難しい。

答えが安くなるほど、問いの価値が上がる

もちろん、問いに対して瞬時に答えが出るというのは革命です。ここは疑う余地がありません。しかし、

AI があれば、全員があらゆる知識を手に入れた

と考えるのは早計だと思います。全員が手に入れたのは、「聞けば答えが返ってくる環境」です。何を聞くかは、まだ同じではない。

同じ AI を使っていても、「これって何?」で終わる人もいれば、「なぜこの仮定が必要なの?」「この二つは本当に別物なの?」「この議論は別の分野にも移せるのでは?」「ここで失敗する例は?」「そもそも問いの立て方が間違っているのでは?」と進んでいく人もいます。

そして、一つ良い問いを持っていると、AI によってその周囲を猛烈な速度で探索できるようになりました。

以前なら一つの問いを調べるだけで一日かかったかもしれない。今なら十個、百個と次の問いに進める。つまり、答えを得る速度が上がったことで、むしろ「最初に何を問えるか」の差がそのまま大きな差になって現れるようになった。

一言でいうと

答えが安くなったからこそ、問いが高くなった。

と、私は感じています。

では、問いはどうやって身につけるのか

ここが問題です。

良い問いを持てと言われても、良い問いは突然空から降ってくるわけではありません。ではどうすればよいのか。

まず、過去の人間が立ててきた問いを大量に知ることだと思います。

人間は長いあいだ、「なぜこうなるのか」「もっと一般化できないか」「この仮定は必要なのか」「例外はないのか」「別の説明はできないのか」「そもそも何を定義すればいいのか」と悩み続けてきました。そして、解決したり、失敗したり、何十年も遠回りしたり、そもそも問い方が悪かったと気づいたりしてきた。

これを学ぶ。答えだけではなく、

人は何を不思議だと思ってきたのか

を学ぶ。

勉強というのは、これまで人類が見つけてきた「問いの型」を、自分の頭に入れる作業でもあるのだと思います。

自分から遠い問いを仕入れる

さらに、問いを増やすなら、自分から少し遠いものを学ぶ方がいいと思っています。

自分がその場で自然に思いつく問いというのは、当然ながら今の自分の知識から生まれます。つまり、いくら新しく見えても、多くは今の自分の延長線上にあります。それだけでは、問いの種類はなかなか増えません。

だから、自分があまり知らない分野を少し学ぶ。普段は読まない本を読む。友人が最近何をしているのか聞く。自分とは全然違う仕事をしている人が、何に困っているのか聞く。

そうすると、ときどき、

えっ、そこを問題にするのか

という問いに出会います。

自分の思考を滑らかに拡張するだけでなく、自分とはほとんど不連続な場所から問いを持ってくる。それを自分の持っている知識とぶつける。

そういうところから、妙に面白い発想が出てくることがあります。このような突然変異を自分から起こしていくことが必要になると思います*2

とはいえ、答えも必要

ここまで「問いが大事」という話をしてきましたが、だから知識は覚えなくていい、という話ではありません。むしろ逆です。良い問いを立てるためには、良い答えを大量に知っている必要があります。

知識がなければ問えない問いは、世の中にいくらでもあります。というより、多分その方が圧倒的に多い。

微分を知らなければ、

微分できない関数をどう扱えばいいのか

とはなかなか思いません。ある理論を知らなければ、「この仮定を外せないのか」とも思えません。ある分野で何がすでに失敗してきたかを知らなければ、昔から何度も試されていることを新しい問いだと思ってしまうかもしれません。

結局、

答えを知る

新しい問いが生まれる

その答えを知る

さらに先の問いが生まれる

という循環になっています。

問いと答えは対立していません。良い答えが、次の良い問いを作ります。

結局、勉強はなくならない

残念ながら(あるいは嬉しいことに)、AI が出てきても勉強そのものはなくならなさそうです。ただし、勉強の意味は少し変わるのかもしれません。

これまでは、答えを知っていることそのものに大きな価値がありました。これからは、その答えの多くを AI がすぐに出してくれます。

それでも自分の中に知識を蓄える意味は残る。なぜなら、その知識が次の問いを作るからです。

そして、自分の中にいろいろな「問い」と「答え」を蓄えていくことで、

自分の力でたどり着ける問いの範囲

そのものが広がっていきます。

AI は、その範囲の中を猛烈な速度で走ってくれます。でも、どの方向へ走るのかを決めるのは人間で、そのための蓄えが必要です。

これから価値を持つのは、たくさん答えを覚えている人ではないのかもしれません。

何を問えばいいかを知っている人。一つ答えを得たあとに、次に何を問うべきかが分かる人。そして、まだ誰も十分に問えていないことに気づける人。

答えが最も簡単に手に入るようになった時代だからこそ、問いが最も価値を持つ。

最近はそんなことを考えています。

ではまた。

*1:この文が AI 臭いと思った方、相当に鋭いです。正直に言うと、本文のほとんどは ChatGPT に書いてもらいました。ただし、本文に含めている論旨自体はすべて私が書いた上で執筆してもらったので、私自身の主張として読んでもらって大丈夫です。

*2:偉そうに言っていますが、私自身がこれまであまり力を入れてこなかった方面でもあります。自戒を込めた宣言です。

Ball の立方体切断定理 Part 2

前回の記事では、立方体の断面積の最大値を求める定理「Ball の立方体切断定理」の証明を行い、この定理の正しさは Ball の積分不等式に帰着されることを見ました。今回はこの不等式の証明を行っていきます。

前回はこちら
smooth-pudding.hatenablog.com

今回の目標

前回、Ball の積分不等式(以下の補題3)を仮定して、Ball の立方体切断定理の証明を行いました。

補題3. 任意の p \geq 2 に対して、以下が成立する。

\displaystyle\int_{\mathbb{R}} \left| \mathrm{sinc} \, x \right|^{p} \mathrm{d} x \leq \sqrt{\dfrac{2}{p}}

等号は p = 2 でのみ成立する。

ただし \mathrm{sinc} は以下で定義されます。


  \displaystyle
  \mathrm{sinc} \, x = \begin{cases}
    1 & (x = 0), \\
    \dfrac{\sin(\pi x)}{\pi x} & (x \neq 0)
  \end{cases}

さらに「次回予告」では、Nazarov–Podkorytov の論文で、以下の主張から Ball の積分不等式を導いていることに触れました。

主定理. g(x) = |\mathrm{sinc} \, x|, f(x) = e^{- \pi x^{2} / 2} とおく。p \geq 2 に対して

\displaystyle
  \int_{0}^{\infty} g(x)^{p} \mathrm{d} x \leq \int_{0}^{\infty} f(x)^{p} \mathrm{d} x

が成り立つ。等号は p = 2 でのみ成り立つ。

今回はこの定理の証明を目標にします。

以下、主定理のステートメントの記法を記事を通じて用いることとします。

layer-cake 表示

今回紹介する手法では、積分を横に切って層状に重ねる形式に変換します。これを layer-cake 表示と呼びます。これを導くために、まずは「横に切る」ための言葉を用意します。

定義4.
Lebesgue 可測関数 h \colon [0, \infty) \to [0, 1] に対して、H \colon (0, 1) \to \mathbb{R} を以下で定義する*1

\displaystyle
  H(y) = \left| \set{ x \mid h(x) > y } \right|

ただし集合 X \subseteq \mathbb{R} の Lebesgue 測度を |X| とした。この Hh の上位関数 (super-level function) と呼ぶ。

上位関数を用いて \int h^{p} を変形してみると、以下のようになります。

\displaystyle
  \begin{aligned}
    \int_{0}^{\infty} h(x)^{p} \mathrm{d} x
    &= \int_{0}^{\infty} \int_{0}^{h(x)} p y^{p - 1} \mathrm{d} y \, \mathrm{d} x \\
    &= \int_{0}^{\infty} \int_{0}^{1} p y^{p - 1} \chi_{\set{ h(x) > y }}(x, y) \mathrm{d} y \, \mathrm{d} x \\
    &= p \int_{0}^{1} y^{p - 1} \int_{0}^{\infty} \chi_{\set{ h(x) > y }}(x, y) \mathrm{d} x \, \mathrm{d} y \\
    &= p \int_{0}^{1} y^{p - 1} H(y) \mathrm{d} y
  \end{aligned}

この表示のことを layer-cake 表示と呼びます。ただし \chi は定義関数です。

この layer-cake 表示を用いて \int f^{p} - \int g^{p} を変形してみます。f, g の上位関数をそれぞれ F, G とすると

\displaystyle
    \int_{0}^{\infty} f(x)^{p} \mathrm{d} x
    -
    \int_{0}^{\infty} g(x)^{p} \mathrm{d} x
    =
    p \int_{0}^{1} y^{p - 1} \left\{ F(y) - G(y) \right\} \mathrm{d} y

となります。よって D(y) = F(y) - G(y) とおけば
\displaystyle
    \int_{0}^{1} y^{p - 1} D(y) \mathrm{d} y
    \geq 0

を示すことが目標になります。

積分のトリック

ちょっとしたトリックを用います。

補題5. 以下の2つの条件を満たすと仮定する。
(a) ある p_{0} \geq 2 において以下が成立する。

\displaystyle
      \int_{0}^{1} y^{p_{0} - 1} D(y) \mathrm{d} y = 0

(b) ある y_{*} \in (0, 1) が存在して、以下が成立する。
\displaystyle
      \begin{gathered}
        y \geq y_{*} \Longrightarrow D(y) \geq 0,\\
        y < y_{*} \Longrightarrow D(y) \leq 0
      \end{gathered}

このとき、任意の p \geq p_{0} に対して

\displaystyle
      \int_{0}^{1} y^{p - 1} D(y) \mathrm{d} y \geq 0

が成立する。また |\set{ y \mid D(y) \neq 0 }| > 0 ならば、等号が成立するのは p = p_{0} の場合に限る。

証明. p = p_{0} のときは明らかなので、p > p_{0} と仮定する。式変形すると

\displaystyle
  \begin{aligned}
    &\hphantom{{}={}} \int_{0}^{1} y^{p - 1} D(y) \mathrm{d} y \\
    &= \int_{0}^{1} y^{p - p_{0}} y^{p_{0} - 1} D(y) \mathrm{d} y \\
    &= \int_{0}^{1} (y^{p - p_{0}} - y_{*}^{p - p_{0}}) y^{p_{0} - 1} D(y) \mathrm{d} y \\
  \end{aligned}

が得られる。ただし最後の等式では (a) に y_{*}^{p - p_{0}} を掛けたものを用いた。(b) より (y^{p - p_{0}} - y_{*}^{p - p_{0}}) D(y) は常に非負である。よってこの積分値は常に非負である。特に |\set{ y \mid D(y) \neq 0 }| > 0 なら、積分値は正の値となる。■

この定理を直観的に説明すると以下のようになります。まず指数が p = p_{0} のときにちょうど 0 になることが保証されていて、かつ D(y)y が大きいところでは正、y が小さいところでは負になっています。y^{p - 1} というファクターは p が大きくなるほど y が大きくなるところからの寄与を増加させ、y が小さくなるところからの寄与を減少させます。その結果、p を大きくすると、D(y) のうち正の部分が積分に与える寄与がより強まり、負の部分が積分に与える寄与がより小さくなります。p = p_{0} でちょうど 0 だったので、p > p_{0} ならこの効果の分大きくなり、正になる、という具合です。

従って目標はずっとシンプルなものに変わり、補題5の (a), (b) を順に示すことになりました。

p = 2 で等式が成立

補題5の (a) が p_{0} = 2 で成立することを確かめます。

補題6. 以下が成立する。

\displaystyle
  \int_{0}^{\infty} g(x)^{2} \mathrm{d} x
  = \int_{0}^{\infty} f(x)^{2} \mathrm{d} x

証明. 右辺を計算すると

\displaystyle
  \int_{0}^{\infty} f(x)^{2} \mathrm{d} x
  = \int_{0}^{\infty} e^{- \pi x^{2}} \mathrm{d} x
  = \dfrac{1}{2}

となる。一方、初等的な計算により*2
\displaystyle
  \int_{0}^{\infty} \dfrac{\sin^{2}(\pi x)}{(\pi x)^{2}} \mathrm{d} x
  = \dfrac{1}{2}

となるので、左辺も同様に \dfrac{1}{2} となる。■

グラフの形状の観察

(b) の証明をする前に、g(x) = |\mathrm{sinc} \, x| の形状を観察してみます。今後このグラフの形状をうまく評価に落としていくので、先に慣れておきましょう。

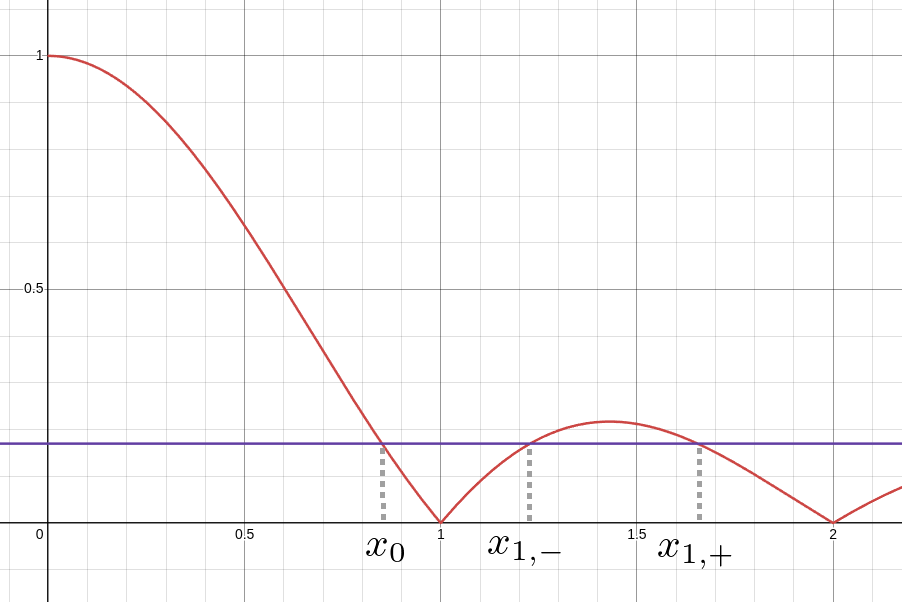
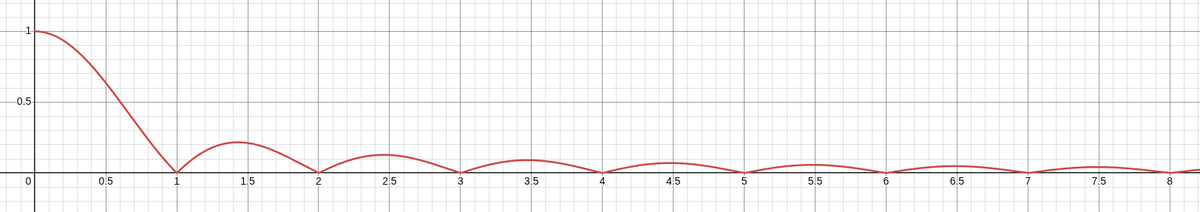
以下が y = g(x) のグラフです。0 \leq x \leq 1 の付近に大きな山があり、そのあとは 1 区切りで小さくなっていく山々が連なっています。

y = g(x) のグラフ。

この形状から予想されるように、各々の山の頂上を y_{0}, y_{1}, y_{2}, \dots とすると、1 = y_{0} > y_{1} > y_{2} > \dots となります。頂上を形式的に定義すれば以下のようになります。

\displaystyle
  y_{0} = 1, \quad
  y_{m} = \max_{m < x < m + 1} g(x) \quad (m = 1, 2, \dots)

また \lim\limits_{x \to \infty} g(x) = 0 なので \lim\limits_{m \to \infty} y_{m} = 0 です。したがって 0 < y < y_{1} かつ y \neq y_{2}, y_{3}, \dots なら、y_{m + 1} < y < y_{m} となる正の整数 m が必ず存在します。

上位関数 G(y) を考える場合は、y_{1} < y < 1 では山ひとつ分、y_{2} < y < y_{1} では山ふたつ分、...というふうに、有限個の山の寄与を合算したものになります。

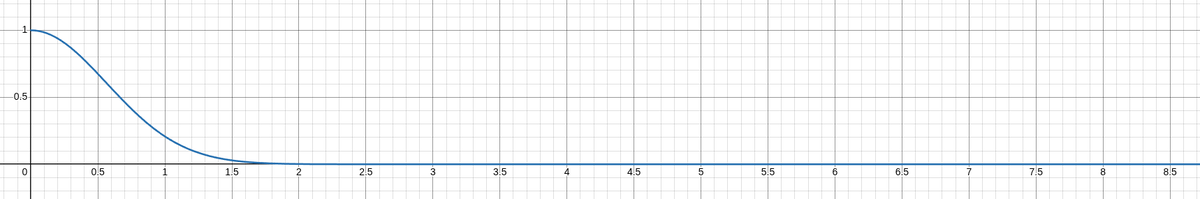
一方、y = f(x) の形状はシンプルです。以下の通り、単調に減少していきます。上位関数 F(y) への寄与も、こちらは山ひとつ分です。

y = f(x) のグラフ。

十分大きな y で D(y) ≧ 0

では補題5 (b) のうち D(y) \geq 0 の領域が存在することを証明します。G(y) への寄与が山ひとつ分の領域、すなわち y_{1} < y < 1 の部分に注目してみます。

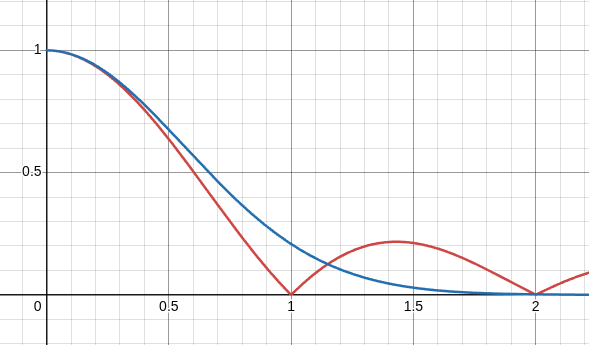
先程のグラフを重ねて、ひとつめの山の近くにズームしてみました。赤い山(= g(x))よりも青い山(= f(x)) のほうがより広がっているので、上位関数としては F(y) > G(y) となっています。つまり D(y) > 0 となっています。

つまり以下が成り立ちます。

補題7. y_{1} < y < 1 のとき D(y) > 0 が成り立つ。

観察で終わりにしてもよいのですが、この部分は \mathrm{sinc} 関数のオイラー積表示を使った綺麗な証明があるので紹介します。

証明. 0 < x < 1 に対して、以下の等式 (オイラー積表示) が成り立つことが知られている。

\displaystyle
  \mathrm{sinc} \, x = \prod_{k = 1}^{\infty} \left( 1 - \dfrac{x^{2}}{k^{2}} \right)

ところで t \in \mathbb{R} に対して 1 - t \leq e^{-t} が成り立つので
\displaystyle
  1 - \dfrac{x^{2}}{k^{2}} \leq e^{- x^{2} / k^{2}}

が成立する。以上から
\displaystyle
  \mathrm{sinc} \, x 
  \leq \prod_{k = 1}^{\infty} e^{- x^{2} / k^{2}}
  = e^{- \pi^{2} x^{2} / 6}

が従う*3。数値比較により - \dfrac{\pi^{2}}{6} < - \dfrac{\pi}{2} となるので、\mathrm{sinc}\,x < e^{- \pi x^{2} / 2} が成り立つ。主張はこの不等式から直ちに従う。■

十分小さな y で D(y) ≦ 0

次に補題5 (b) のうち D(y) \leq 0 の領域が存在することを示します。実はこれはほぼ自明です。

補題8. D(y) \leq 0 となる y \in (0, 1) が存在する。

証明.
もしすべての y \in (0, 1)D(y) > 0 が成り立つならば

\displaystyle
  \int_{0}^{1} y D(y) \mathrm{d} y > 0

が成立する。しかしこれは補題6に矛盾する。■

0 < y < y_1 で D(y) は単調増加

次に D(y)0 < y < y_{1} で単調増加であることを示します。これと補題7, 8 を組み合わせれば、晴れて補題5の (b) を主張できます。

F(y) は常に微分可能です。また上位集合のラインがちょうど山頂に重なる y = y_{1}, y_{2}, \dots を除くと、G(y) も微分可能です。また G(y) は山頂に重なるタイミングも含めて連続性はあります。したがって、y = y_{1}, y_{2}, \dots を除いた領域で D'(y) を評価して D'(y) \geq 0 を示す方針で考えます。

まず F(y) は具体的に計算することができます。

\displaystyle
  f(x) = e^{- \pi x^{2} / 2} > y
  \iff x < \sqrt{\dfrac{2}{\pi} \log \dfrac{1}{y}}

と変形できるので、F(y) = \sqrt{\dfrac{2}{\pi} \log \dfrac{1}{y}} となります。微分を計算すると
\displaystyle
  F'(y) = - \dfrac{1}{y\sqrt{2 \pi \log(1 / y)}}

が得られます。

補題9. F(y) は微分可能で、以下が成立する。

\displaystyle
  F'(y) = - \dfrac{1}{y\sqrt{2 \pi \log(1 / y)}}

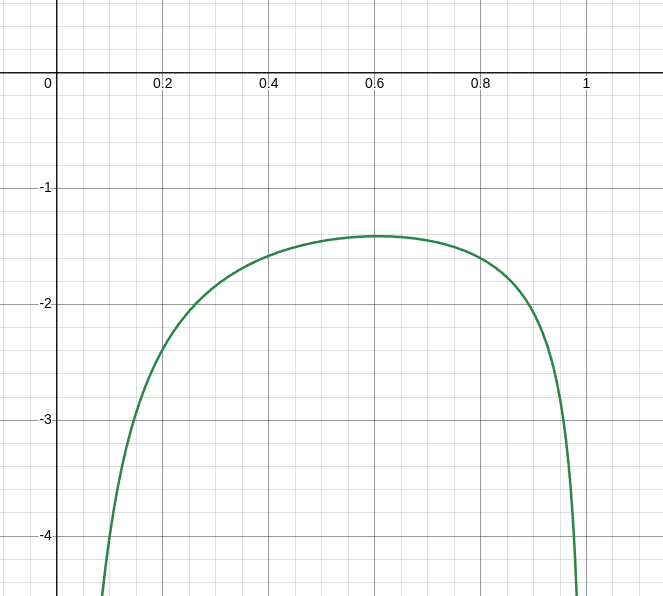
以下は y を横軸にとった F'(y) のグラフです。y_{1}0.5 よりも小さいことを考えると、0 < y < y_{1} では F'(y) は単調増加であることが分かります。

F'(y) のグラフ

G(y) の方は幾分厄介です。f(x) は逆関数を計算できたため直接 F'(y) を計算できましたが、g(x) はそうはいきません。代わりに微分の値を不等式評価していきます。目標は次です。

補題10. m を正の整数とする。G(y) は区間 (y_{m + 1}, y_{m}) 上で微分可能で、以下の評価が成立する。

\displaystyle
  | G'(y) | \geq \dfrac{2}{\pi} + m + m^{2}

証明. G(y) は各山ごとの切り取り幅が寄与している。y \in (y_{m + 1}, y_{m}) のときは、0 番目から m 番目の山からの寄与の合計である。それぞれについて考える。

まず 0 番目の山について、g(x_{0}) = y となる 0 < x_{0} < 1 をとる。また k \, (\leq m) 番目の山については、切り取りの左端と右端があるので、左端を x_{k,-}, 右端を x_{k,+} とする。すなわち g(x_{k,-}) = g(x_{k,+}) = y であり、k < x_{k,-} < x_{k,+} < k + 1 である。

交点の定義

これらを用いると G(y) は以下のように表される。

\displaystyle
G(y) = x_{0} + \sum_{k = 1}^{m} (x_{k, +} - x_{k, -})

次に y を変化させたときに x_{0}, x_{k, -}, x_{k, +} がどのように変動するかを考える。g(x) = y の両辺を y で微分して整理すると

\displaystyle
  g'(x) \dfrac{\mathrm{d} x}{\mathrm{d} y} = 1
  \iff
  \dfrac{\mathrm{d} x}{\mathrm{d} y} = \dfrac{1}{g'(x)}

となる。よって、各区間の端点の移動による効果は g'(x) の逆数によって与えられる。

ところで、y を増加させたときの各端点の移動は、かならず G(y) を減少させる方向の効果を与える。したがって

\displaystyle
  G'(y) = - \dfrac{1}{|g'(x_{0})|} - \sum_{k = 1}^{m} \left(
    \dfrac{1}{|g'(x_{k,-})|} + \dfrac{1}{ | g'(x_{k, +}) | }
  \right)

と表される。

各項を評価しよう。まず 0 < x < 1 のとき

\displaystyle
  g(x) = \dfrac{\sin(\pi x)}{\pi x}
  = \int_{0}^{1} \cos(\pi x u) \mathrm{d} u

と表示できる。そこで十分小さい h をとると
\displaystyle
  \begin{aligned}
    &\hphantom{{}={}} | g(x_{0} + h) - g(x_{0}) | \\
    &\leq \int_{0}^{1} \left| \cos(\pi x_{0} u + \pi h u) - \cos(\pi x_{0} u) \right| \mathrm{d} u \\
    &= 2 \int_{0}^{1} \left| \sin\dfrac{2 \pi x_{0} u + \pi h u}{2} \right| \left| \sin\dfrac{\pi h u}{2} \right| \mathrm{d} u \\
    &\leq 2 \int_{0}^{1} \dfrac{\pi |h| u}{2} \mathrm{d} u \\
    &= \dfrac{\pi |h|}{2}
  \end{aligned}

が得られるので、結局
\displaystyle
  | g'(x_{0}) | = \lim_{h \to 0} \left| \dfrac{ g(x_{0} + h) - g(x_{0}) }{h} \right|
  \leq \dfrac{\pi}{2}

となる。

残りの山についても評価しよう。k < x < k + 1 とし、u = x - k とおく。\sin(\pi u) \leq \pi u なので

\displaystyle
  0 < g(x) 
  = \dfrac{\sin(\pi u)}{\pi(k + u)}
  \leq \dfrac{u}{k + u}
  \leq \dfrac{u}{k}

が成り立つ。また
\displaystyle
  g'(x) = \dfrac{\cos(\pi u) - g(x)}{k + u}

である。よって
\displaystyle
  \begin{aligned}
    |g'(x)|
    &= \dfrac{| \cos(\pi u) - g(x) |}{ k + u } \\
    &\leq \dfrac{ | \cos(\pi u) | + | g(x) | }{ k + u } \\
    &\leq \dfrac{ 1 + u/k }{ k + u} \\
    &= \dfrac{1}{k}
  \end{aligned}

となる。

以上から

\displaystyle
  \begin{aligned}
    |G'(y)|
    &= \dfrac{1}{|g'(x_{0})|} + \sum_{k = 1}^{m} \left(
      \dfrac{1}{|g'(x_{k, -})|} + \dfrac{1}{|g'(x_{k, +})|}
    \right) \\
    &\geq \dfrac{2}{\pi} + \sum_{k = 1}^{m} 2k \\
    &= \dfrac{2}{\pi} + m + m^{2}
  \end{aligned}

が従う。■

さて、ピースを組み立てて最後のピースを完成させます。

補題11. D(y)0 < y < y_{1} で狭義単調増加である。

証明. m を正の整数とし、y_{m + 1} < y < y_{m} とする。F'(y) の具体的な表示から F'(y) \neq 0 と分かるので、G'(y) \leqq 0 と合わせて

\displaystyle
  D'(y) = F'(y) - G'(y)
  = |F'(y)| \left( \dfrac{|G'(y)|}{|F'(y)|} - 1 \right)

と変形できる。

ところで

\displaystyle
  y_{m + 1}
  = \max_{m + 1 < x < m + 2} g(x)
  \geq g\left( m + \dfrac{3}{2} \right)
  = \dfrac{1}{\pi (m + 3/2)}

が成り立つ。さらに 0 < y < y_{1} において F'(y) は単調増加なので |F'(y)| は単調減少である。よって以下が成り立つ。
\displaystyle
  \begin{aligned}
  |F'(y)| 
  &\leqq \left|F'\left( \dfrac{1}{\pi (m + 3/2)} \right)\right| \\
  &= \dfrac{\pi(m + 3/2)}{\sqrt{ 2 \pi \log( \pi (m + 3/2) ) }}
  \end{aligned}

以上から
\displaystyle
  \begin{aligned}
    \dfrac{|G'(y)|}{|F'(y)|}
    &\geq \left( \dfrac{2}{\pi} + m + m^{2} \right)
    \dfrac{ \sqrt{2 \pi \log(\pi (m + 3/2))} }{ \pi( m + 3/2) } \\
    &= \dfrac{m^{2} + m + 2/\pi}{m + 3/2}
    \sqrt{
      \dfrac{2}{\pi} \log\left( \pi \left( m + \dfrac{3}{2} \right) \right)
    }
  \end{aligned}

が得られる。さらに m \geq 1 より
\displaystyle
\begin{aligned}
  &\hphantom{{}={}}m^{2} + m + \dfrac{2}{\pi} \\
  &= m + \dfrac{3}{2} + (m^{2} - 1) + \left(\dfrac{2}{\pi} - \dfrac{1}{2}\right) \\
  &> m + \dfrac{3}{2}
\end{aligned}

および
\displaystyle
  \log\left( \pi \left( m + \dfrac{3}{2} \right) \right)
  \geq \log \dfrac{5 \pi}{2}
  > \dfrac{\pi}{2}

が成り立つ*4。したがって
\displaystyle
  \dfrac{|G'(y)|}{|F'(y)|} > 1

である。以上から D'(y) > 0 なので、y_{m + 1} < y < y_{m} で狭義単調増加である。

D は連続なので、0 < y < y_{1} で狭義単調増加である。■

主定理の証明・まとめ

最後にすべてまとめます。

主定理の証明.
定義4 に従い、f, g の上位関数をそれぞれ F, G と定義する。また D(y) = F(y) - G(y) と定義する。補題6より、D は補題5の (a) を p = 2 で満たす。また補題7, 8, 11 より D は補題5の(b)を満たす。実際、D の連続性から D(y) = 0 となる 0 < y \leq y_{1} が存在するので、そのひとつを y_{*} とすればよい。よって補題5より任意の p \geq 2 に対して

\displaystyle
  \int_{0}^{1} y^{p - 1} D(y) \mathrm{d} y \geq 0

が成立する。Layer-cake 表示を経由すれば、これより主張が従う。等式が p = 2 でのみ成立することは |\set{ y \mid D(y) \neq 0 }| \geq 1 - y_{1} > 0 から従う。■

以上で証明が終わりました。素朴な問題なのに、証明でいろいろな技術が輝いていてとても面白い定理でしたね。

ではまた。

次回↓
smooth-pudding.hatenablog.com

参考文献

[1] Keith Ball, “Cube slicing in \mathbb R^n,” Proceedings of the American Mathematical Society, 97 (3), 465–473, 1986. MR 840631.
doi: 10.1090/S0002-9939-1986-0840631-0

[2] Fedor L. Nazarov and Anatoliy N. Podkorytov, “Ball, Haagerup, and Distribution Functions,” in V. P. Havin and N. K. Nikolski (eds.), Complex Analysis, Operators, and Related Topics, Operator Theory: Advances and Applications, Vol. 113, Birkhäuser, Basel, pp. 247–267, 2000.
doi: 10.1007/978-3-0348-8378-8_21


\displaystyle

*1:厳密には H\infty 値をとりうるので、もうすこし h に条件を課す必要がある。この記事で扱う f, g では問題ない。

*2:Dirichlet 積分に変形する方法や、Parseval 等式を利用する方法などがある。

*3:\sum\limits_{k = 1}^{\infty} \frac{1}{k^{2}} = \frac{\pi^{2}}{6} はバーゼル問題と呼ばれるよく知られた等式です。

*4:\pi < 4 より \frac{2}{\pi} > \frac{2}{4} = \frac{1}{2} が成り立つ。また \log \frac{5 \pi}{2} = 2.061..., \frac{\pi}{2} = 1.5707... より \log \frac{5 \pi}{2} > \frac{\pi}{2} が成り立つ。

Ball の立方体切断定理 Part 1

今回は単位立方体の断面積の最大値を与える定理、その名もBall の立方体切断定理を紹介します。

単位立方体の断面積を最大化する

単位立方体とは、1辺の長さが1の立方体です。これを平面で切ったときの断面を考えます。このときの断面積の最大値はいくらでしょうか?

Gemini が描いてくれた立方体を切る図。怪しさ満点。

面に平行な断面は面積 1 なので、最大値は少なくとも 1 以上です。こういう問題は大抵対称性の高い方法が最適なので、断面が正六角形になるような切り方を思い浮かべるのではないでしょうか。

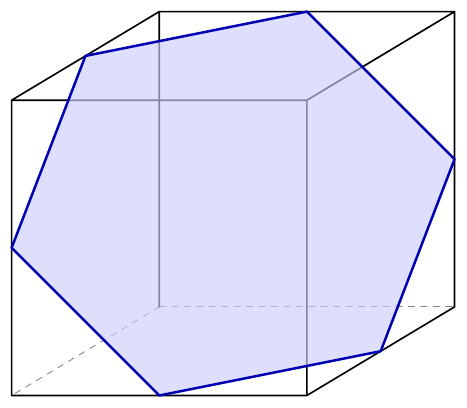
断面が正六角形になる切り方

実際に計算してみると、断面積は \dfrac{3\sqrt{3}}{4} \approx 1.299 となります。これが正解かと思いきや、もっと断面積が大きくなる切り方があります。それは以下のような切り方です。

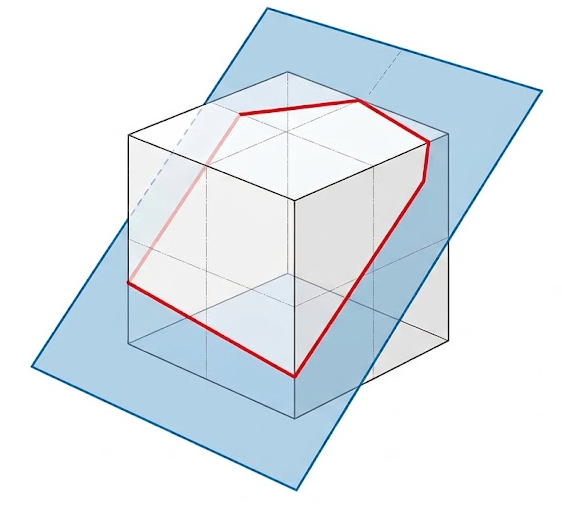
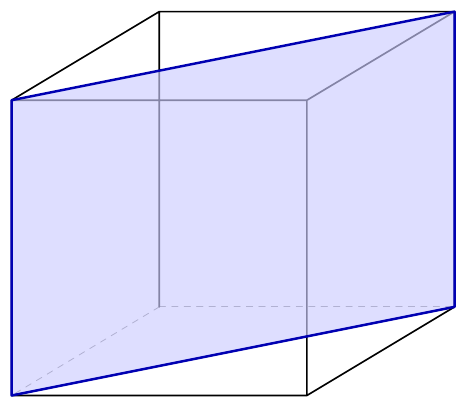
断面積が √2 になる切り方

実際、この切り方の場合、断面積は \sqrt{2} \approx 1.414 になります。

もっと断面積が大きくなる切り方は存在するでしょうか?答えはいいえです。つまり断面積 \sqrt{2} が最大値です。

Ball はこの問題を n 次元に一般化して解決し、以下の定理を証明しました*1。現在では Ball の立方体切断定理 (Ball's cube slicing theorem) と呼ばれているようです。

主定理 (Ball's cube slicing theorem).
n を2以上の自然数とする。n 次元単位立方体 Q_{n} を以下で定義する。

Q_{n} = \left[ - \dfrac{1}{2}, \dfrac{1}{2} \right]^{n} \subseteq \mathbb{R}^{n}

また単位ベクトル a \in \mathbb{R}^{n} および r \in \mathbb{R} に対して、a に垂直な超平面 H_{r, a} を以下で定義する。
H_{r, a} = \set{ x \in \mathbb{R}^{n} \mid a \cdot x = r }

このとき Q_{n} \cap H_{r, a}n - 1 次元体積 v_{n, r, a}
v_{n, r, a} \leq \sqrt{2}

を満たす。等号は例えば
r = 0, \quad a = \dfrac{1}{\sqrt{2}} (1, 1, 0, \dots, 0)

のときに成立する。

この記事ではこの定理の証明を与えます。以下、この記事を通じてこのステートメントの記法を用います。

原点を通る場合への帰着

まずは r = 0 の場合に帰着させます。すなわち以下を示します。

補題1. 自然数 n \geq 2、単位ベクトル a \in \mathbb{R}^{n} および任意の r \in \mathbb{R} に対し、v_{n, r, a} \leq v_{n, 0, a} が成り立つ。

証明. r \in \mathbb{R} に対して S(r) = Q_{n} \cap H_{r,a} とし、S(r)n - 1 次元体積を A(r) とおく。

以下、X_{1}, X_{2} \subseteq \mathbb{R}^{n} および実数 t \in \mathbb{R} に対して、以下のように書くこととする。

\begin{gathered}
X_{1} + X_{2} = \set{ x_{1} + x_{2} \in \mathbb{R}^{n} \mid x_{1} \in X_{1}, x_{2} \in X_{2} }, \\
t X_{1} = \set{ t x_{1} \in \mathbb{R}^{n} \mid x_{1} \in X_{1} }
\end{gathered}

立方体は原点について対称なので、S(r) = - S(-r) が成り立つ。また S(r), S(-r) \subseteq Q_{n} であり、Q_{n} は凸集合なので、

\dfrac{1}{2} S(r) + \dfrac{1}{2} S(-r) \subseteq Q_{n}
が成り立つ。さらに任意の x_{1} \in H_{r, a}, x_{2} \in H_{-r, a} に対して
\dfrac{x_{1} + x_{2}}{2} \cdot a
= \dfrac{r + (-r)}{2}
= 0
より (x_{1} + x_{2}) / 2 \in H_{0,a} が成り立つ。よって
\dfrac{1}{2} S(r) + \dfrac{1}{2} S(-r) \subseteq S(0)
が成立する。

(S(r) + S(-r)) / 2n - 1 次元体積を \bar{A}(r) とおく。包含関係から \bar{A}(r) \leq A(0) である。また平行移動によって両超平面を H_{0, a} と同一視して Brunn-Minkowski の定理*2を適用すると

\bar{A}(r)^{1/(n - 1)} \geq \dfrac{1}{2} A(r)^{1/(n-1)} + \dfrac{1}{2} A(-r)^{1/(n-1)}
が成立する。さらに S(r) = - S(-r) より A(r) = A(-r) なので、結局 \bar{A}(r) \geq A(r) を得る。以上から A(r) \leq A(0) が従う。これは主張にほかならない。■

断面積を具体的に表示

断面として原点を通るもののみ考えればよいことが分かりました。さらに断面積を具体的に表示します。

補題2. 自然数 n \geq 2 および単位ベクトル a \in \mathbb{R}^{n} に対し、以下が成り立つ。

\displaystyle v_{n,0,a} = \int_{\mathbb{R}} \prod_{j} \mathrm{sinc}(a_{j} t) \mathrm{d} t

ただし
\displaystyle \mathrm{sinc}(x) = \begin{cases}
1 & (x = 0), \\
\dfrac{\sin(\pi x)}{\pi x} & (x \neq 0)
\end{cases}

と定義する。

Ball の論文に沿って、なんと確率論を使って計算していきます。

証明. X_{1}, X_{2}, \dots, X_{n}[ - 1/2, 1/2 ] 上の一様分布を持つ独立な確率変数とし、

\displaystyle X = \sum_{j} a_{j} X_{j}

と定める。X の確率密度関数を f(x) とすると f(0) = v_{n,0,a} が成り立つ。実際、微小な \mathrm{d}r に対して r < X < r + \mathrm{d}r となる確率は f(r)\mathrm{d}r と表される。一方、これは立方体のうち2つの超平面 H_{r,a}H_{r+\mathrm{d}r,a} に挟まれた部分の体積であり、v_{n,r,a}\mathrm{d}r と近似できる*3

X_{j} の特性関数は以下のとおりである。

\displaystyle \mathbb{E}[ e^{is X_{j}}] = \mathrm{sinc}\left( \dfrac{s}{2 \pi} \right)

独立性から、X の特性関数 \varphi_{X}(s)
\displaystyle
\begin{aligned}
\varphi_{X}(s)
&= \mathbb{E}[ e^{i s X} ] \\
&= \prod_{j} \mathbb{E}[ e^{i s a_{j} X_{j}} ] \\
&= \prod_{j} \mathrm{sinc}\left( \dfrac{a_{j} s}{2 \pi} \right)
\end{aligned}

と計算できる。よって Fourier 逆変換により*4
\displaystyle
f(0) = \dfrac{1}{2 \pi} \int_{\mathbb{R}} \prod_{j} \mathrm{sinc}\left( \dfrac{a_{j} s}{2 \pi} \right) \mathrm{d} s

を得る。最後に s = 2 \pi t とおけば主張が従う。■

Ball の積分不等式で証明を閉じる

Ball の論文では、以下の不等式を証明しています。現在はBall の積分不等式 (Ball's integral inequality)と呼ばれているようです。

補題3. 任意の p \geq 2 に対して、以下が成立する。

\displaystyle\int_{\mathbb{R}} \left| \mathrm{sinc} \, x \right|^{p} \mathrm{d} x \leq \sqrt{\dfrac{2}{p}}

等号は p = 2 でのみ成立する。

ここでは一旦この主張を認めて、主定理を証明してしまいましょう。

主定理の証明.
ある j について |a_{j}| \geq \dfrac{1}{\sqrt{2}} ならば、断面を j 番目の座標に垂直な座標超平面へ射影すれば

\displaystyle v_{n, 0, a} \leq \dfrac{1}{|a_{j}|} \leq \sqrt{2}

となるので、成立する*5

以下、すべての j について |a_{j}| < \dfrac{1}{\sqrt{2}} が成り立つと仮定する。 \sum_{j} a_{j}^{2} = 1 なので、多変数の Hölder の不等式より

\displaystyle
\int_{\mathbb{R}} \prod_{j} \left| \mathrm{sinc}( a_{j} t ) \right| \mathrm{d} t
\leq {\prod_{j}^{}}'
\left(
  \int_{\mathbb{R}} | \mathrm{sinc}(a_{j} t) |^{1 / a_{j}^{2}} \mathrm{d} t
\right)^{a_{j}^{2}}

が成り立つ。ただし \prod'a_{j} \neq 0 なる範囲での積である。a_{j} \neq 0 のとき、補題3より
\displaystyle
\begin{aligned}
  \int_{\mathbb{R}} | \mathrm{sinc}(a_{j} t) |^{1/a_{j}^{2}} \mathrm{d} t
  &= \dfrac{1}{|a_{j}|} \int_{\mathbb{R}} | \mathrm{sinc} \, \tau |^{1 / a_{j}^{2}} \mathrm{d} \tau \quad (\tau = |a_{j}| t) \\
  &\leq \dfrac{1}{|a_{j}|} \sqrt{ 2 a_{j}^{2} } \\
  &= \sqrt{2}
\end{aligned}

が従う。以上から
\displaystyle
  \int_{\mathbb{R}} \prod_{j} \left| \mathrm{sinc}( a_{j} t ) \right| \mathrm{d} t
  \leq {\prod_{j}}' \sqrt{2}^{a_{j}^{2}}
  = \sqrt{2}

が従う。

以上と補題1, 2 から

\displaystyle
\begin{aligned}
v_{n, r, a}
&\leq v_{n, 0, a} \\
&= \int_{\mathbb{R}} \prod_{j} \mathrm{sinc}(a_{j} t) \mathrm{d} t \\
&\leq \int_{\mathbb{R}} \prod_{j} \left| \mathrm{sinc}(a_{j} t) \right| \mathrm{d} t \\
&\leq \sqrt{2}
\end{aligned}

となり、主定理が示された。■

よって、最後の関門は Ball の積分不等式 (補題3) のみとなりました。

次回予告:Nazarov–Podkorytov による Ball の積分不等式の証明

さて、補題3の証明ですが、Ball の論文ではかなり気合の不等式評価をしています。具体的には Taylor 展開しまくって |\mathrm{sinc} \, x|^{p} を各点で頑張って評価しています。

以前この論文を読んだときここで挫折したのですが、GPT に「もっといい証明ない?」と聞いてみたところ Nazarov–Podkorytov の手法がシンプルだよと教えてくれました。

Nazarov–Podkorytov の手法では以下を証明します。

次回の主定理. g(x) = |\mathrm{sinc} \, x|, f(x) = e^{- \pi x^{2} / 2} とおく。p \geq 2 に対して

\displaystyle
  \int_{0}^{\infty} g(x)^{p} \mathrm{d} x \leq \int_{0}^{\infty} f(x)^{p} \mathrm{d} x

が成り立つ。

これから Ball の積分不等式が直ちに従うことを確認します。右辺は Gauss 積分なので具体的に計算することができて

\displaystyle
  \int_{0}^{\infty} f(x)^{p} \mathrm{d} x
  = \int_{0}^{\infty} e^{- \pi p x^{2} / 2} \mathrm{d} x
  = \dfrac{1}{\sqrt{2 p}}

となります。f, g はどちらも偶関数なので、積分範囲を広げれば Ball の積分不等式が従います。

Nazarov–Podkorytov の手法では、各点で f(x)g(x) を直接比較する代わりに、閾値 \lambda を動かしたときの上位集合 \set{ f > \lambda }\set{ g > \lambda } の大きさを比較します。これにより、(各点で気合で評価するのと比べると) かなり見通しのよい証明になります。

今回はここまで。次回は具体的に Nazarov–Podkorytov の手法を解説します。

ではまた。

続き↓
smooth-pudding.hatenablog.com

参考文献

[1] Keith Ball, “Cube slicing in \mathbb R^n,” Proceedings of the American Mathematical Society, 97 (3), 465–473, 1986. MR 840631.
doi: 10.1090/S0002-9939-1986-0840631-0

[2] Fedor L. Nazarov and Anatoliy N. Podkorytov, “Ball, Haagerup, and Distribution Functions,” in V. P. Havin and N. K. Nikolski (eds.), Complex Analysis, Operators, and Related Topics, Operator Theory: Advances and Applications, Vol. 113, Birkhäuser, Basel, pp. 247–267, 2000.
doi: 10.1007/978-3-0348-8378-8_21

*1:Ball なのに球じゃなくて立方体なんかい、って思った人は手を挙げてください。私もです。

*2:Brunn–Minkowski theorem - Wikipedia を参照。気が向いたらまた紹介記事を書きます。

*3:ここはやや数学的にごまかしています。ちゃんと正当化したい場合は、まず区間に対する確率を断面積の積分として表し、Radon–Nikodym 微分で密度を構成した上で、連続性を用いて f(0)=v_{n,0,a} を確認してください。

*4:厳密には、a によっては右辺の積分が絶対収束しない場合があります。この場合は広義積分として解釈します。なお、後の主定理の証明でこの表示を用いるケースでは絶対収束します。

*5:j 以外の座標の取りうる範囲を Q_{n-1} まで広げると、n-1 次元体積が射影のヤコビアンの逆数分、すなわち 1 / |a_{j}| となり、これで上から評価されます。

日本語の LLM “方言” の考察

まずは、これを読んでください。

新しいことを始めるときは、まず軸を置いて全体を整理しておくのがかなり効きます。いきなり細部を掘るより、何パターンか回して傾向を拾い、刺さる方向が見えてきたところで具体案に落とす方が強いです。この方法は高い柔軟性を持つので、途中で問題が出ても論点を切って調整できます。結果に差が見えたら、その違いを方向性が固まったサインと読んで、完成形に寄せていけばよいでしょう。

どうでしょう。かなり「AI 臭さ」を感じませんか?

文法的にはそこまでおかしくないし、言っていることも普通に分かります。しかし、日本語ネイティブが同じ内容を書くと、たぶんこうはなりません。なにが原因なのでしょう?

最近 GPT や Claude と話していて、このような「意味は完全に分かるのに、なぜか AI が書いたと分かる日本語」が気になっていました。そこで今回は、こういう表現を勝手に「LLM 方言」と呼んで、何が起きているのか考えてみます。

なぜ冒頭の文章は「方言」のように感じるのか

まず、冒頭の文章にはわざと LLM が使いがちな表現を大量に詰め込んでいます。

  • 軸を置く
  • 整理する
  • 効く
  • 掘る
  • 回す
  • 拾う
  • 刺さる
  • 落とす
  • 強い
  • 高い柔軟性を持つ
  • 論点を切る
  • ~と読む
  • 寄せる

多い。

もちろん、この中には普通の日本語として使われる表現もあります。「整理する」なんて日常的に使いますし、「若者に刺さる」「仕様に落とし込む」なども別におかしくありません。どうも問題は単語そのものではなさそうです。

ではどこが違うのでしょうか。どうやら、使える意味の範囲を広く取りすぎていることにありそうです。いくつか具体的に見てみましょう。

強い

ChatGPT にディズニーランドとディズニーシーを比較してもらったところ、

ディズニーシーはこの点が強いです。一方でディズニーランドはこの点が強いです。

というふうな表現が返ってきました。「傾向が強い」「個性が強い」「印象が強い」なら普通ですが、「この点で優れている」「こちらの方が魅力が大きい」という意味まで「強い」で表現するのはすこし違和感があります。「この点が強い」と言われても意味は分かる。でも普通そうは言わんやろ、という感じがあります。

効く

この方法はかなり効きます。

ここで具体例を入れると効きます。

この整理の仕方が効きます。

「薬が効く」「対策が効く」「この工夫が効いている」なら自然ですが、LLM は「有効である」「効果がある」「理解しやすくなる」「改善につながる」あたりまで全部「効く」で済ませがちです。

刺さる

この機能は初心者に刺さります。

この構成は数学好きに刺さります。

この説明は直感派の人に刺さります。

「この広告は若者に刺さる」くらいなら特に違和感はありませんが、「その人に適している」「その人が好みそう」「その人にとって分かりやすい」といったところまで「刺さる」が侵食してきます。

掘る・切る

この論点をもう少し掘りましょう。

いや、掘り下げろ。

日本語でも「ちょっと掘ってみる」のような口語表現はありますが、LLM は本来「掘り下げる」と言うところでも平然と「掘る」と言います。同じように、

論点を切る

と言うこともありますが、こちらも普通なら「切り分ける」「分ける」あたりでしょう。この二つは先ほどまでとは少し違って、複合動詞をやたら短くしているようにも見えます。

持つ

この方式は高い柔軟性を持ちます。

何が言いたいかは分かります。しかし日本語なら「この方式は柔軟性が高い」で十分でしょう。

この手法は一定の限界を持ちます。

両者は緊張関係を持っています。

なども、「一定の限界があります」「緊張関係にあります」の方が自然です。

こうして並べてみると、LLM 方言は単純な誤用とは少し違います。一つ一つを見ると、日本語にも似た使い方がちゃんとあります。ただ、ネイティブなら文脈によって別々の単語を選ぶところを、LLM は少数の単語に大量の仕事をさせている。どうもこのあたりが、あの独特な「AI 臭さ」を作っているように思います。

仮説:英語から来ているのでは?

では、なぜこんなことが起きるのでしょうか。

ここで一つ気になることがあります。先ほど挙げた単語を英語にしてみると、妙に対応関係が見えてきます。

例えば「強い」は strong です。英語では strong pointstrong appealstrong candidatestrong preference など、strong をかなり広い意味で使えます。

DisneySea is stronger in this respect.

のような表現も自然です。これをそのまま日本語の単語に対応させれば、

ディズニーシーはこの点が強いです。

のできあがりです。

「効く」は work を考えると分かりやすいです。

This approach works.

This works well for beginners.

Adding an example here works well.

英語では、このように「うまくいく」「効果がある」を work で広く表現できます。日本語なら「この方法は有効です」「初心者にはこの方法がうまくいきます」「ここで具体例を入れると分かりやすくなります」などと表現が分かれるところですが、これを広く「効く」に対応させれば、LLM おなじみの

この方法はかなり効きます。

ができあがります。

「持つ」も英語の have を考えると納得できます。

This approach has some limitations.

This system has good compatibility with existing software.

のように英語では have がかなり広く使えます。日本語では「限界がある」「互換性が高い」と言うところまで「have → 持つ」としてしまえば、「限界を持つ」「高い互換性を持つ」という日本語になります。

さらに「read → 読む」、「see → 見る」 も怪しいです。英語では read the result as ... のように read を「解釈する」という意味で使えますし、see も視覚的に「見る」だけではなく、認識する、理解する、解釈するといった意味を広く持っています。そのせいなのか、LLM は、

この結果は~と読めます。

これを一種の最適化として見ることができます。

のような言い方をよくします。

ほかにも 「dig into → 掘る」、「pick up → 拾う」 あたりも同じような雰囲気を感じさせます。もちろん全部が綺麗に一対一対応するわけではなく、「軸」「寄せる」「落とす」まで英語由来だと言い始めるとだいぶ怪しくなってきます。ただ少なくとも「強い」「効く」「持つ」「見る」「読む」あたりについては、「英語では広い意味を持っている単語に対応する日本語を、そのまま同じぐらい広く使ってしまっている」と考えると、綺麗に説明できてしまうように思います。ある種「逆ルー大柴」と言えそうです(?)。

LLM 方言が意味するもの

ここまでの LLM 方言は、主に GPT や Claude と話している中で見つけたものです。どちらもアメリカの企業が開発しているモデルで、英語のデータから非常に大きな影響を受けていることは間違いないでしょう。

一方で「LLM はまず英語で考えて、それを日本語に翻訳している」と考えるのは単純すぎるようです。Anthropic が Claude の内部を調べた研究では、異なる言語の間で共有される概念表現が観察されており、少なくとも単純な逐語翻訳のような仕組みではなさそうです。
www.anthropic.com

それでも、その「概念」の作られ方に英語の影響が強く残っている可能性はあるのではないでしょうか。例えば英語では strong 一語で表せる意味の領域があり、日本語ではその領域を「強い」「優れている」「魅力が大きい」「有力である」など複数の単語で分担しているとします。LLM の中でできあがった意味の領域と日本語の単語の意味の領域が本当は少しずれているのに、生成するときに日本語の「強い」をその領域全体へ当てはめてしまう。そう考えると、「意味は合っているのに、その単語はそこでは使わない」という LLM 方言ができるのも納得できます。

またこのことから、Sakana AI の Namazu のようなアプローチの意味が見えてきます。Namazu は高性能な既存の基盤モデルに対して、日本語や日本の文化・社会的文脈に合わせた事後学習を行う方向で開発されています。Sakana AI 自身も、日本語能力を含めてベースモデルから改善することを評価しています。
sakana.ai

個人的には「Namazu の日本語はとても自然だ」と感じているのですが、もしかするとこういった事後学習で「この概念なら日本人はどの単語を選ぶか」というレベルの調整がなされていて、その結果 LLM 方言が薄くなっているのかもしれません。

また、この現象を逆に考えると、LLM 方言を観察することが英語の勉強につながる可能性もあります。

この方法は効く。

は日本語として妙でも、

This approach works.

なら自然ですし、

この点が強い。

は妙でも、

stronger in this respect

なら普通に使えます。

我々が英語を話すときは日本語の単語の範囲に引きずられて英単語を狭く使ってしまうことがありますが、LLM 方言はちょうどその逆です。LLM の変な日本語を真似せず、その一歩手前にある英語だけ真似すれば、むしろ自然な英語に近づくのかもしれません。やはり逆ルー大柴ですね(???)。

まとめ

今回は、LLM が話す独特な日本語を「LLM 方言」として眺めてみました。単なる誤用ではなく、日本語にも存在する単語を、本来よりずっと広い意味で使っている。そしてその意味の広がりを調べてみると、英語の strongworkhaveseeread などと妙によく対応している、というのが今回の仮説でした。

思いつきの考察なので、どこまでちゃんと正当化できるかはわかりません。ただ、この考察を読んだみなさんが「AI 臭い」文の見方が変わったのなら、この記事を書いてよかったなと思います。

みなさんも、LLM の方言を見つけたら、温かく見守ってあげてください。ではまた。

Namazu を Claude から呼べるようにする

Sakana Namazu というモデルがあります。

sakana.ai

ベースは中国のモデルですが*1、日本語や日本文化についてしっかり事後学習してあるので、とても自然な日本語を話してくれます。

今回はそんな Namazu を Claude から呼び出す方法を紹介します。

Namazu の利用方法

簡単に利用するには、Sakana Chat がおすすめです。Namazu とお話できます。

chat.sakana.ai

大阪モードのレスポンスは、ネイティブの私にとっても申し分ないクオリティです。

また Namazu を使った翻訳サービス Sakana Translate もあります。

chat.sakana.ai

コマンドラインで使えるようにする

チャットするだけでも楽しいのですが、それでは物足りなくなるのが人情というもの。嬉しいことに、最近 Namazu API が公開されました。

sakana.ai

これを使ってコマンドラインでも利用できるようにできます。


だいたいこんな感じだったと思います(うろ覚え)

  1. 冒頭のページにアクセス
  2. 今から始める的なボタンを押す
  3. アカウントを登録する
  4. 支払い情報を登録する
  5. クレジットを入金する
  6. API キーを作成してトークンを生成して控えておく
  7. 適当なシステムを組んで API でリクエストを飛ばせるようにする
  8. コマンドでこれを呼び出せるようにする

最後の2つを詳しく説明します。

API でリクエストを飛ばせるようにする方法

OpenAI 互換なので、Python で簡単に作ることができます。Claude Code をお持ちなら「OpenAI 互換の API でアクセスできるシステムを作って」で完成すると思います。

私の環境では以下が生成されました。OS は Ubuntu 24.04 です。このスクリプトの場合は、SAKANA_API_KEY という環境変数にトークンを登録すれば準備完了です。

#!/usr/bin/env python3
"""Sakana Namazu API (Chat Completions, OpenAI互換) を呼び出す薄いラッパー。

Namazu API にはタスク別の専用エンドポイントは存在しない。プロンプト
(system/user) は呼び出し側(オーケストレーター)が組み立て、このスクリプトは
認証・HTTP通信・出力整形のみを担当する。

認証: このスクリプトと同じディレクトリの .env に SAKANA_API_KEY=... を保存しておく
(このスクリプトが自動で読む)。

使用例:
    # 直接テキストを渡す
    namazu --system "あなたは有能なアシスタントです。" \\
        --user "ここに聞きたいこと・依頼したいことを書く"

    # ファイルから読む
    namazu --system "..." --user-file input.txt

    # 標準入力から読む (--user / --user-file を省略した場合)
    cat input.txt | namazu --system "..."

    # 生のレスポンスJSONが欲しい場合
    namazu --system "..." --user "..." --json
"""

from __future__ import annotations

import argparse
import os
import sys
from pathlib import Path

from dotenv import load_dotenv
from openai import OpenAI

DEFAULT_BASE_URL = "https://api.sakana.ai/v1"
DEFAULT_MODEL = "sakana-namazu"


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(
        description="Sakana Namazu Chat Completions API を呼び出す",
        formatter_class=argparse.RawDescriptionHelpFormatter,
        epilog=__doc__,
    )
    parser.add_argument(
        "--system", default=None, help="system プロンプト (省略可)"
    )
    text_group = parser.add_mutually_exclusive_group()
    text_group.add_argument("--user", default=None, help="user メッセージの本文")
    text_group.add_argument(
        "--user-file", type=Path, default=None, help="user メッセージ本文を読むファイル"
    )
    parser.add_argument(
        "--model", default=DEFAULT_MODEL, help=f"モデルID (デフォルト: {DEFAULT_MODEL})"
    )
    parser.add_argument(
        "--temperature", type=float, default=0.3, help="温度パラメータ (デフォルト: 0.3)"
    )
    parser.add_argument(
        "--max-tokens", type=int, default=4096, help="最大出力トークン数 (デフォルト: 4096)"
    )
    parser.add_argument(
        "--json", action="store_true", help="レスポンス全体をJSONで出力する"
    )
    return parser.parse_args()


def read_user_text(args: argparse.Namespace) -> str:
    if args.user is not None:
        return args.user
    if args.user_file is not None:
        return args.user_file.read_text(encoding="utf-8")
    if sys.stdin.isatty():
        raise SystemExit(
            "エラー: --user / --user-file が無い場合は標準入力からテキストを渡してください。"
        )
    return sys.stdin.read()


def main() -> None:
    load_dotenv(Path(__file__).parent / ".env")
    args = parse_args()
    user_text = read_user_text(args)

    messages = []
    if args.system:
        messages.append({"role": "system", "content": args.system})
    messages.append({"role": "user", "content": user_text})

    api_key = os.environ.get("SAKANA_API_KEY")
    if not api_key:
        raise SystemExit(
            "エラー: SAKANA_API_KEY が設定されていません。namazu/.env に "
            "SAKANA_API_KEY=... を記入してください。"
        )
    client = OpenAI(base_url=DEFAULT_BASE_URL, api_key=api_key)

    response = client.chat.completions.create(
        model=args.model,
        messages=messages,
        temperature=args.temperature,
        max_tokens=args.max_tokens,
    )

    if args.json:
        print(response.model_dump_json(indent=2))
    else:
        print(response.choices[0].message.content)


if __name__ == "__main__":
    main()

コマンドラインで Namazu を呼び出せるようにする

Python のスクリプトができたら、実はあと1ステップで終わりです。スクリプトのおいてあるディレクトリで以下を実行すれば完了です。(事前に uv のインストールが必要です)

uv tool install --editable .

これが完了すると namazu --user "ぬるぽ" などとすると「ガッ」と返してくれるようになりました。かわいいね。

Claude から Namazu を呼び出せるようにする

最後に Claude から呼び出せるようにします。Claude Code で「namazu のコマンドをよしなに呼び出せるスキルをグローバルに作って」と依頼したら一瞬で完成です。ちなみに私のところで作られた SKILL.md は以下のとおりです。

---
name: namazu
description: Send a request to the Sakana Namazu API (Chat Completions, OpenAI-compatible) via the globally installed `namazu` CLI. A general-purpose system/user request wrapper — not tied to any fixed task (e.g. not a proofreading-specific tool).
---

# Namazu Skill

Runs the globally installed `namazu` command to call the Sakana Namazu Chat Completions API.

`namazu` is installed system-wide (`uv tool install --editable`, source at `~/.local/share/namazu-tools/`), so it works from any directory in any Claude Code session — no per-project setup needed. The API key is already configured in `~/.local/share/namazu-tools/.env`.

`namazu` itself has no fixed purpose: it's a thin wrapper that just sends whatever `--system` / `--user` content it's given to the Namazu model. What task it performs (proofreading, drafting, analysis, translation, etc.) is entirely determined by the prompt passed in at call time.

## Instructions

1. Run `namazu` via the Bash tool with the arguments supplied after `/namazu`, e.g.:
   ```
   namazu --system "<system prompt>" --user "<user text>"
   ```
2. If the system/user content isn't clear from the invocation, ask the user what to send rather than guessing at a task.
3. Long input can be piped or passed via `--user-file` instead of `--user`.
4. Return the response text to the user. Only pass `--json` when raw response metadata (e.g. token usage) is explicitly wanted.

## Options (passed through to the CLI)

| Option | Description |
|---|---|
| `--system` | system prompt (optional) |
| `--user` / `--user-file` | user message content (mutually exclusive; omit both to read stdin) |
| `--model` | model ID (default `sakana-namazu`) |
| `--temperature` | default `0.3` |
| `--max-tokens` | default `4096`; raise explicitly for long input |
| `--json` | print the full response JSON instead of just the text |

Full reference: `namazu --help`.

## Usage

```
/namazu --system "<system prompt>" --user "<user text>"
```

## Examples

```
/namazu --system "あなたは有能なアシスタントです。" --user "この文章を3行で要約して"
/namazu --system "You are a translator." --user-file draft.txt
cat notes.txt | namazu --system "箇条書きに整理して"
```

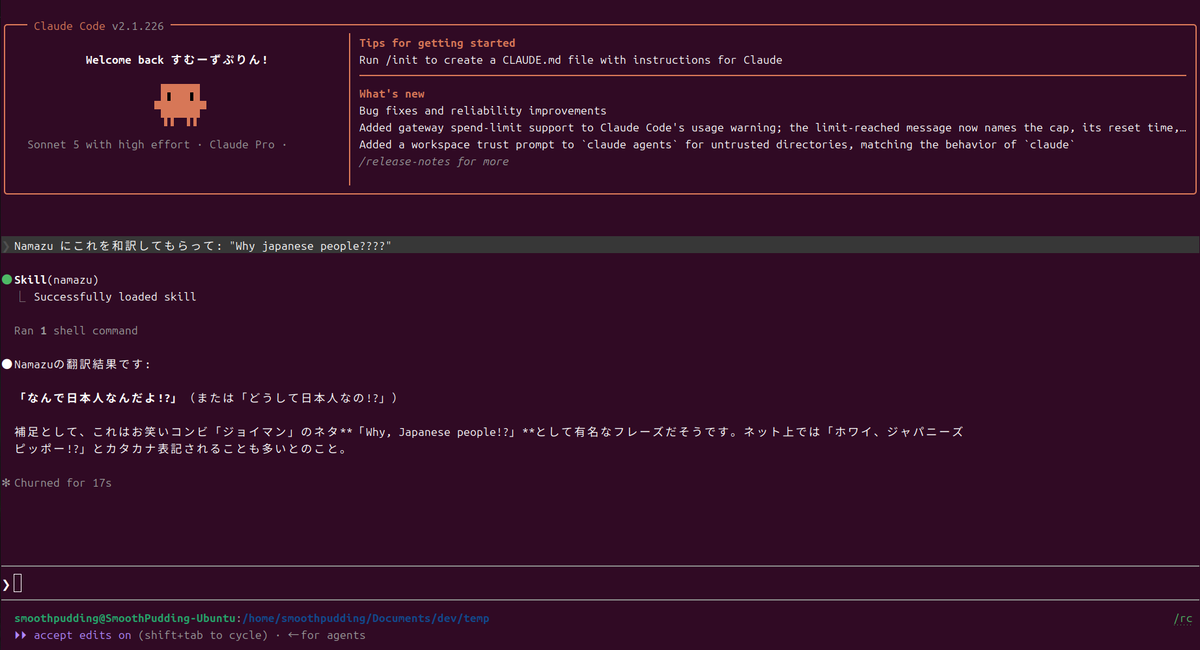
実行してみた結果がこちら。

なんだこいつ〜!?

ではまた。

*1:現在は Kimi K2.6 がベースのようです。